Library
Vision language
34 published papers.
 7:13
FLEX-WAM: Flexible Block-Causal World-Action Models for Long-Horizon Imagination and Planning
VLA models · deck
2610.05483
 6:28
Long-WAM: Scaling the Context of World-Action Models
VLA models · deck
2610.10528
 7:04
Agentic World Action Models
VLA models · deck
2610.30136
 7:46
Impossible Videos
Video generation · deck
 5:21
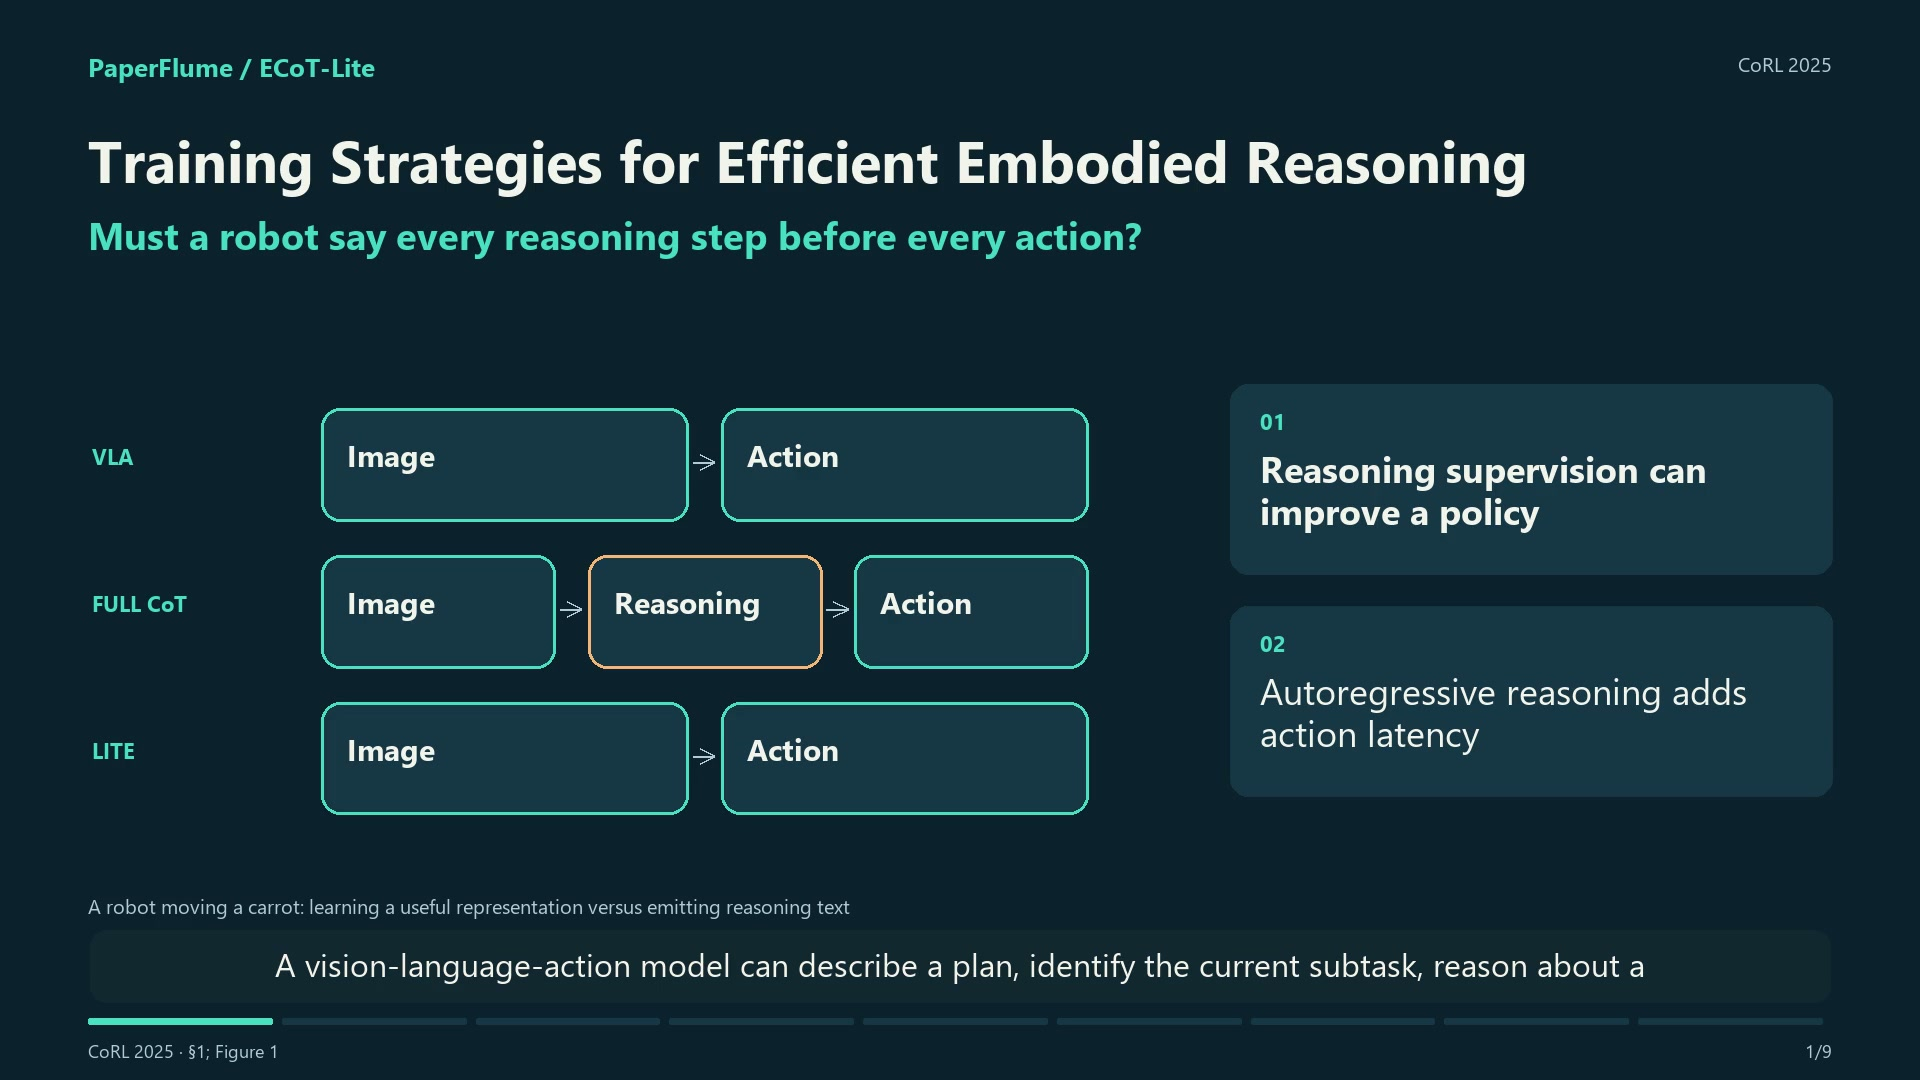
Training Strategies for Efficient Embodied Reasoning
VLA models · deck
 5:33
LARA: Latent Action Representation Alignment for Vision-Language-Action Models
VLA models · deck
 5:31
Prototype-Based Test-Time Adaptation of Vision-Language Models
Test-time scaling · deck
 6:23
The Lie We Tell: Correcting the Euclidean Fallacy in Vision Language Action Policies via Score Matching on Tangent Space
VLA models · deck
 6:44
UniPercept: Towards Unified Perceptual-Level Image Understanding across Aesthetics, Quality, Structure, and Texture
Multimodal LLMs · deck
 7:12
What Does Vision Tool-Use Reinforcement Learning Really Learn? Disentangling Tool-Induced and Intrinsic Effects for Crop-and-Zoom
Multimodal LLMs · deck
 6:23
When RAG Hurts: Diagnosing and Mitigating Attention Distraction in Retrieval-Augmented LVLMs
Multimodal LLMs · deck
 6:25
SPARC: Separating Perception And Reasoning Circuits for Test-time Scaling of VLMs
Multimodal LLMs · deck
 5:28
Active Exploring like a Pigeon: Reinforcing Spatial Reasoning via Agentic Vision-Language Models
Video understanding · deck
 7:19
MoDA: Modulation Adapter for Fine-Grained Visual Understanding in Instructional MLLMs
Multimodal fusion · deck
 7:09
VideoTrace-R1: Long Video-based Retrieval-Augmented Generation via Reinforcement Learning
Video understanding · deck
 6:44
SciVideoBench: Benchmarking Scientific Video Reasoning in Large Multimodal Models
Video understanding · deck
 7:16
Tabero: Learning Gentle Manipulation with Closed-Loop Force Feedback from Vision, Touch, and Language
Grasping · deck
 6:18
Temporal Difference Calibration in Sequential Tasks: Application to Vision-Language-Action Models
VLA models · deck
 6:36
Escaping the Diversity Trap in Robotic Manipulation via Anchor-Centric Adaptation
Learning from demonstration · deck
 7:13
SurrogateSHAP: Training-Free Contributor Attribution for Text-to-Image (T2I) Models
Open-vocabulary perception · deck
 5:29
Responsible Text-to-Image Diffusion: Interpretable and Linearly Controllable Semantics for Fair and Safe Generation
Open-vocabulary perception · deck
 6:15
SpatialReward: Bridging the Perception Gap in Online RL for Image Editing via Explicit Spatial Reasoning
Segmentation · deck
 7:34
DirectEdit: Step-Level Accurate Inversion for Flow-Based Image Editing
Open-vocabulary perception · deck
 6:01
Concept-Guided Tokenization: Closing the Gap Between Reconstruction and Generation
Open-vocabulary perception · deck
 8:16
CG-MLLM: Captioning and Generating 3D Content via Multi-modal Large Language Models
Neural rendering · deck
 5:58
Let Language Constrain Geometry: Vision–Language Models as Semantic and Spatial Critics for 3D Generation
Neural rendering · deck
 7:03
SpatioLM: Towards General Physical Spatial Intelligence in Vision-Language Models
VLA models · deck
 5:55
O³Afford: One-Shot 3D Object-to-Object Affordance Grounding for Generalizable Robotic Manipulation
Open-vocabulary perception · deck
 7:55
ScrewSplat: An End-to-End Method for Articulated Object Recognition
Gaussian splatting · deck
 6:58
XR-1: Towards Versatile Vision-Language-Action Models via Learning Unified Vision-Motion Representations
Learning from demonstration · deck
 6:43
Tackling View-Dependent Semantics in 3D Language Gaussian Splatting
Gaussian splatting · deck
 5:06
RoboArena: Distributed Real-World Evaluation of Generalist Robot Policies
VLA models · deck
 7:39
GraspVLA: a Grasping Foundation Model Pre-trained on Billion-scale Synthetic Action Data
Grasping · deck
 5:20
π₀.₅: a Vision-Language-Action Model with Open-World Generalization
Mobile manipulation · deck